Wenn Starkregen vorhergesagt wird, müssen lokale Behörden Entscheidungen treffen, noch bevor sie genau wissen, wie sich die Situation entwickeln wird. Worauf sollten die Einsatzkräfte ihren Fokus setzen? Welche Schutzmaßnahmen sollten Vorrang haben? Eine KI-basierte Hochwasservorhersage kann bei diesen Entscheidungen helfen, muss jedoch nützliche Informationen liefern, solange noch Zeit zum Handeln bleibt.
DeepWaive ist ein Deep-Learning-Modell von FloodWaive, das die Berechnungszeiten für Hochwasserszenarien von Stunden oder Tagen auf Sekunden oder Minuten verkürzen kann. Gemeinsam mit WestAI untersuchte FloodWaive, wie sich die zugrunde liegenden Modelle effizient trainieren und an regionale Gegebenheiten anpassen lassen. Dieser Artikel erläutert unseren Ansatz und zeigt, wie DeepWaive in der Praxis eingesetzt wird.
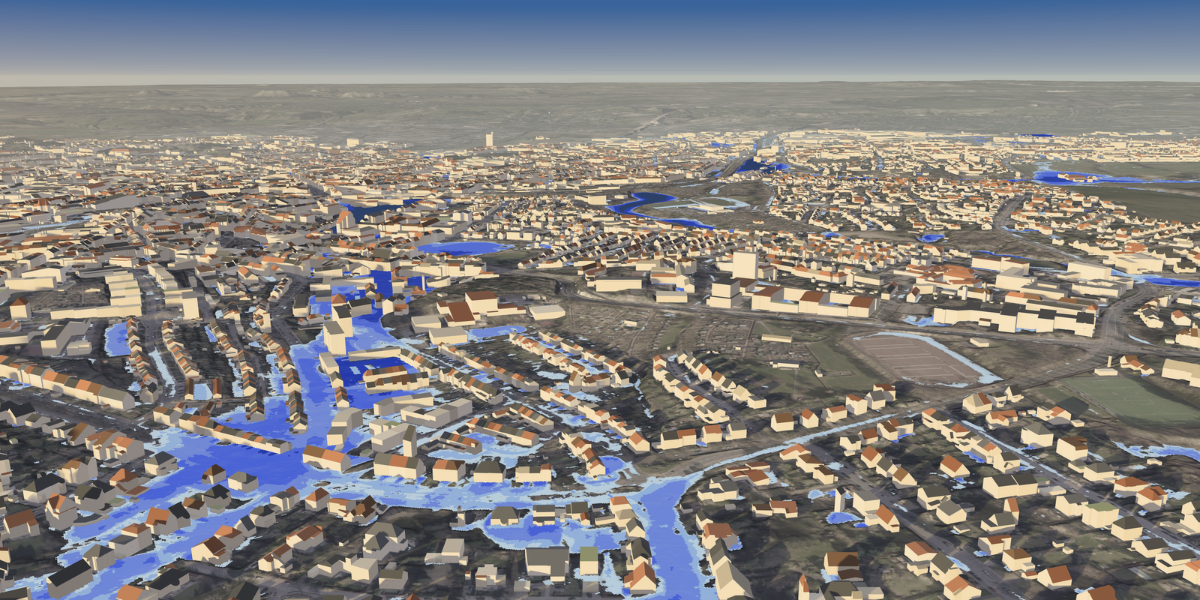
Eine Niederschlagsprognose gibt Auskunft über das Wetter, das auf eine Region zukommt. Um die Folgen abzuschätzen, sind detaillierte Karten erforderlich, die zeigen, wie sich das Wasser durch diese Region bewegen wird. Sie verdeutlichen, welche Straßen zu Abflusswegen werden, wo sich Wasser ansammelt und wie sich Wassertiefe und Fließgeschwindigkeit im Laufe der Zeit verändern. Diese Details sind für Kommunen von Bedeutung, die einschätzen müssen, welche Straßen, Gebäude und Infrastruktureinrichtungen gefährdet sind. Die Erstellung solcher Hochwasserkarten für mehrere plausible Niederschlagsprognosen ist jedoch mit einem erheblichen Rechenaufwand verbunden und erfordert oft Stunden oder Tage an Berechnungen.
DeepWaive lernt aus hydrodynamischen Simulationen, um diese Berechnung zu beschleunigen. Seine schnellen Vorhersagen beruhen auf im Vorfeld durchgeführten Vorbereitungen. Dazu gehören (1) die Erstellung von Referenzszenarien, (2) das Training des KI-Modells anhand dieser Szenarien und (3) das Testen, wie gut das Modell in neuen, bisher unbekannten Situationen funktioniert. Im Rahmen unserer Forschungskooperation mit WestAI haben wir untersucht, wie diese Vorbereitungen effektiver gestaltet werden können. Wir untersuchten, welche Ressourcen für ein wiederverwendbares Basismodell erforderlich sind und inwieweit eine lokale Anpassung die regionale Leistungsfähigkeit verbessern könnte, ohne den gesamten Trainingsprozess wiederholen zu müssen.
Vom Niederschlag bis zur Überschwemmung
Hydrodynamische Modellierungen zeigen, wie Gelände, Niederschlag und andere Ereignisse die Bewegung des Wassers beeinflussen. Ein digitales Höhenmodell beschreibt die Höhe der Bodenoberfläche als detaillierte Karte, während Gebäude und andere Hindernisse die möglichen Fließwege beeinflussen. Niederschlag, von außen in das Gebiet fließendes Wasser und das bereits vorhandene Wasser bestimmen den Verlauf der Simulation.
Bei einem typischen numerischen Ansatz wird die Oberfläche in Rechenzellen unterteilt. Physikalische Gleichungen beschreiben, wie sich Wasser zwischen benachbarten Zellen bewegt und wie sich die Strömung über aufeinanderfolgende Zeitschritte verändert. Die daraus resultierenden Karten zeigen die Wassertiefe über dem Boden sowie die Strömungsgeschwindigkeit einschließlich ihrer Richtung. Da die Zellen miteinander interagieren, können Zustände stromaufwärts Hochwasser in einiger Entfernung beeinflussen. Wird beispielsweise ein Gebäude als undurchlässig dargestellt, wird die berechnete Strömung durch benachbarte Zellen umgeleitet.
Die Simulation hängt von ihren Eingabedaten ab. Bei einer operativen Vorhersage stammen die Niederschlagsdaten möglicherweise aus einer Wettervorhersage. Bei einem Trainingsszenario können sie gezielt festgelegt werden. Folglich können verschiedene Wettervorhersagen unterschiedliche Hochwasserkarten für dasselbe Gelände ergeben. Dadurch wird die Unsicherheit hinsichtlich des bevorstehenden Wetters von der Berechnung seiner möglichen Auswirkungen vor Ort getrennt.
Eine feinere räumliche Auflösung erhöht die Anzahl der miteinander interagierenden Zellen, während längere Ereignisse mehr Schritte erfordern. Die Wiederholung der Simulation für alternative Niederschlagsmuster führt zu weiteren Durchläufen. Dies ist wertvoll, um mögliche Ergebnisse zu untersuchen. Der hohe Rechenaufwand schränkt jedoch ein, wie viele Szenarien in der kurzen Zeit bewertet werden können, die vor der Ausgabe einer Warnung zur Verfügung steht.
Ein trainierbares Hochwasser-Ersatzmodell
DeepWaive ist eine trainierte Annäherung – oder ein Ersatzmodell – dieser numerischen Berechnung. Einfach ausgedrückt: Es lernt, Hochwasserkarten vorherzusagen, ohne jedes Mal die vollständige Simulation durchführen zu müssen. Zum Trainieren werden Geländedaten und Ereignisangaben mit Hochwasserkarten abgeglichen, die von hydrodynamischen Modellen generiert wurden. Das Netzwerk vergleicht seine Vorhersagen mit diesen Referenzwerten und passt seine Parameter an, um die Abweichung zu verringern. Dank seiner Transformer-Architektur kann das Modell Beziehungen zwischen verschiedenen Orten in den Eingabedaten abbilden. Dies ist wichtig, wenn der Verlauf einer Überschwemmung an einem Ort von den Bedingungen an anderen Orten abhängt.
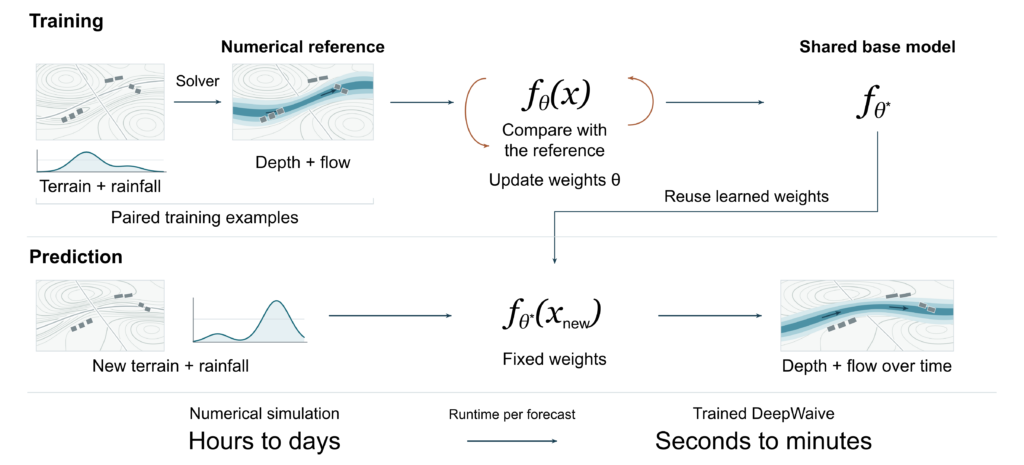
Abbildung 1. Numerische Simulationen liefern die Referenzkarten für das Training von DeepWaive. Nach dem Training werden die gelernten Parameter des Modells (Gewichte θ*) für neue Vorhersagen wiederverwendet. Die Vorhersage kann Sekunden bis Minuten dauern, anstatt der Stunden bis Tage, die ein numerischer Löser benötigt. Die tatsächlichen Laufzeiten hängen vom Gebiet, der Auflösung, der Ereignisdauer und der Hardware ab. © FloodWaive.
Simulationen ermöglichen die Erstellung vielfältiger Trainingsszenarien, einschließlich Ereignissen, für die keine detaillierten Beobachtungsdaten vorliegen. Jede Simulation verknüpft vorgegebene Eingabebedingungen wie Niederschlag und Gelände mit der entsprechenden Hochwasserdynamik. Dies bietet einen Ansatz, physikalisches Wissen in das maschinelle Lernen einzubeziehen.
Die Erstellung von Referenzszenarien und das Training des Netzwerks sind rechenintensive Vorbereitungsschritte, die vor dem operativen Einsatz abgeschlossen werden. Die dadurch erzielte Zeitersparnis kommt dann bei jeder Vorhersage zum Tragen. Nach dem Training verarbeitet DeepWaive neue Geländedaten und Niederschlagswerte mit festen Gewichtungen, ohne dass für jede Vorhersage die vollständige numerische Simulation erneut durchgeführt oder das Modell neu angepasst werden muss. Abbildung 1 veranschaulicht diese Schritte.
Wir bezeichnen dieses wiederverwendbare Netzwerk als Basismodell für die Hochwasservorhersage. Es handelt sich um ein gemeinsames Basismodell, das anhand vieler verschiedener Szenarien trainiert wurde und für den Einsatz in mehreren Regionen vorgesehen ist. Für eine neue Region erhält das Modell die Geländekarte dieser Region als Eingabe. Die Anpassung des Modells geht noch einen Schritt weiter und verändert das Gelernte. Lokale Referenzsimulationen können diese Anpassung unterstützen, wenn Vorhersagen den lokalen Bedingungen genauer entsprechen müssen. Daraus ergeben sich zwei miteinander verbundene Investitionsentscheidungen: Wie viel soll durch ein breit angelegtes Training gelernt werden, und wie stark soll das Modell für eine bestimmte Anwendung angepasst werden?
Anpassung der Modellkapazität an die Arbeitslast
Die Zusammenarbeit vereinte drei Elemente: das DeepWaive-Modell und die Simulationspipeline von FloodWaive, die Forschung zu Anpassungsmethoden am Labor für Werkzeugmaschinen und Fertigungstechnik (WZL) der RWTH Aachen sowie die Rechenressourcen von WestAI auf dem Hochleistungsrechnercluster CLAIX der Universität. Unser Ausgangspunkt war der in Skalierungsstudien zu Sprachmodellen etablierte Ansatz. Diese Studien untersuchen, wie sich die Vorhersagequalität verändert, wenn Modellgröße, Trainingsdaten und Rechenleistung erhöht werden. Zusätzliche Parameter können komplexere Zusammenhänge abbilden, doch ihr Nutzen hängt davon ab, dass genügend Trainingsbeispiele und Rechenaufwand zur Verfügung stehen, um sie sinnvoll zu nutzen.
Wir haben drei Modellgrößen mit etwa 125 Millionen, 500 Millionen und 2 Milliarden Parametern verglichen. Für die untersuchte Trainingskonfiguration ergaben die Vergleiche, dass rund 500 Millionen Parameter das beste Gleichgewicht zwischen Vorhersagequalität und Trainingsaufwand darstellen. Bei häufigen Vorhersagen verlagert sich der Schwerpunkt auf die Inferenzkosten, also die Zeit und Rechenleistung, die benötigt werden, um das Modell für jede Vorhersage auszuführen. Aus diesem Grund hat FloodWaive die Entwicklung größerer und kompakterer Varianten fortgesetzt, die für unterschiedliche Arbeitslasten geeignet sind.
Die Zuweisung von Grafikprozessoren (GPUs) stellte einen weiteren technischen Kompromiss dar. Das parallele Training auf mehreren GPUs verteilt die Rechenlast, jedoch müssen die GPUs Informationen austauschen, um ihre Modellkopien synchron zu halten. In unseren Tests ergab sich bei etwa acht GPUs das beste Verhältnis zwischen Vorhersagequalität und Ressourcenverbrauch. Den begrenzten Nutzen des Einsatzes noch weiterer GPUs führen wir hauptsächlich auf den Kommunikations-Overhead zurück, d. h. auf Verzögerungen, die durch den Datenaustausch zwischen den GPUs verursacht werden.
Datenvolumen und Abdeckung beantworten unterschiedliche Fragen
Unsere Tests deuten darauf hin, dass der Nutzen zusätzlicher Trainingsdaten davon abhängt, wie vielfältig die Szenarien sind und wie viele Daten das Modell bereits gesehen hat. Zu unserer Überraschung flachten die Verbesserungen der Vorhersagequalität in einigen Experimenten ab, als weitere Beispiele ähnlicher Art hinzugefügt wurden. Wir interpretieren dies als Zeichen dafür, dass das getestete Modell aus dieser Art von Daten bereits das Meiste gelernt hatte, was es lernen konnte. Ein separater FloodWaive-Entwicklungstest im September 2025 deckte eine spezifischere Lücke in der Szenarioabdeckung auf. In diesem Test durfte sich Wasser hinter einer Barriere in einer simulierten Landschaft ansammeln. Die Berechnung wurde dann ab diesem Punkt fortgesetzt, wobei die Barriere entfernt wurde. In der Vorhersage des Modells blieb das angesammelte Wasser an Ort und Stelle, anstatt abzufließen. Dieser Übergang, bei dem eine Barriere verschwindet, während Wasser dahinter zurückgehalten wird, war in den Trainingsszenarien nicht abgebildet worden. Der Test legte eine gezielte Erweiterung des Trainingssatzes nahe, um diese Lücke zu schließen: Szenarien, in denen Barrieren während eines Ereignisses entstehen oder verschwinden. Nach dem Training sollte die resultierende Abflussreaktion sorgfältig ausgewertet werden. Weitere Beispiele mit unveränderten Hindernissen würden diesen fehlenden Übergang nicht direkt liefern. Abbildung 2 veranschaulicht die im Entwicklungstest beobachtete Modellreaktion und das physikalische Verhalten, das das vorgeschlagene zusätzliche Training motivierte.
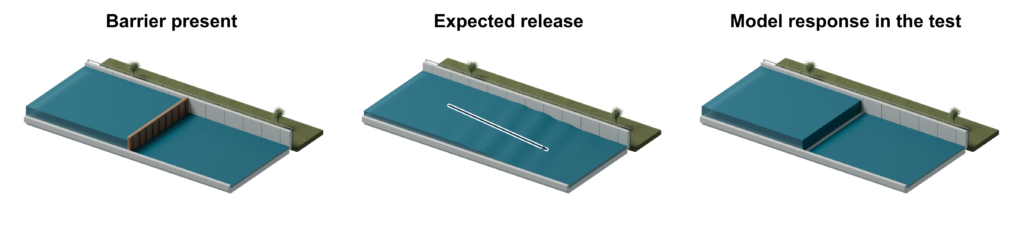
Abbildung 2. Diese schematische Darstellung zeigt einen FloodWaive-Entwicklungstest, der in einem Zustand begann, in dem sich hinter einer Barriere Wasser angesammelt hatte. Die Barriere wurde anschließend entfernt. Die beiden rechten Abbildungen vergleichen den erwarteten Abfluss (frei fließendes Wasser) mit der Modellreaktion im Test (das Wasser bleibt eingeschlossen). Dieses Ergebnis legt nahe, Trainingsbeispiele hinzuzufügen, die sich verändernde Hindernisse beinhalten, wie beispielsweise Barrieren, die während einer Überschwemmung erscheinen oder verschwinden. © FloodWaive.
Weitere Beispiele einer bekannten Art führten zu immer geringeren Verbesserungen des Modells. Im Gegensatz dazu deckte der Barriere-Test eine Art von Hochwasserszenario auf, mit dem das Modell während des Trainings noch nie konfrontiert worden war. Um diese Lücke zu schließen, sind Beispiele für genau diesen Übergang erforderlich.
Anpassung des gemeinsamen Modells an regionale Gegebenheiten
Die lokale Anpassung bietet eine weitere Anwendungsmöglichkeit für zusätzliche Beispiele. Regionale Referenzsimulationen können sich vom umfassenden Trainingskorpus (dem großen, vielfältigen Datensatz, der für das anfängliche Training verwendet wurde) unterscheiden. Zu diesen Unterschieden können unter anderem die Darstellung des Geländes und die zugrunde liegenden Modellannahmen gehören. Dies macht regionale Simulationen wertvoll für die Anpassung des Basismodells an ein bestimmtes Gebiet. Wir haben die regionale Anpassung anhand von Referenzsimulationen für die StädteRegion Aachen, den Regionalbezirk, zu dem die Stadt Aachen gehört, evaluiert.
Bei der vollständigen Feinabstimmung wird das gesamte Basismodell anhand regionaler Daten weiter trainiert, wobei sich alle seine Parameter ändern können. Dieser Ansatz baut auf dem auf, was das Basismodell bereits gelernt hat, und verleiht ihm volle Flexibilität bei der Anpassung an die Region. Der Nachteil besteht darin, dass ein großes Netzwerk optimiert werden muss und jede Region ein eigenes vollständiges Modell erhält, das separat gepflegt werden muss. Wir haben diesen Ansatz mit alternativen Methoden verglichen, bei denen eingeschränkt wird, welche Parameter während der Anpassung angepasst werden.
Bei der Low-Rank-Anpassung (LoRA) bleiben die vortrainierten Gewichte unverändert. Anstatt alle Parameter zu ändern, lernt das Modell eine kleine Korrektur zur regionalen Anpassung. Diese Korrektur wird durch das Produkt zweier kleinerer Matrizen dargestellt. Durch die Begrenzung ihres Rangs wird die Flexibilität der Korrektur eingeschränkt. Dadurch wird die Anzahl der trainierbaren Parameter im Vergleich zu einer vollständigen Feinabstimmung erheblich reduziert. Die Vorhersage kombiniert die ursprüngliche Transformation mit dieser gelernten Korrektur. Abbildung 3 zeigt die Beziehung zwischen den “eingefrorenen” Gewichten und den trainierbaren Komponenten.
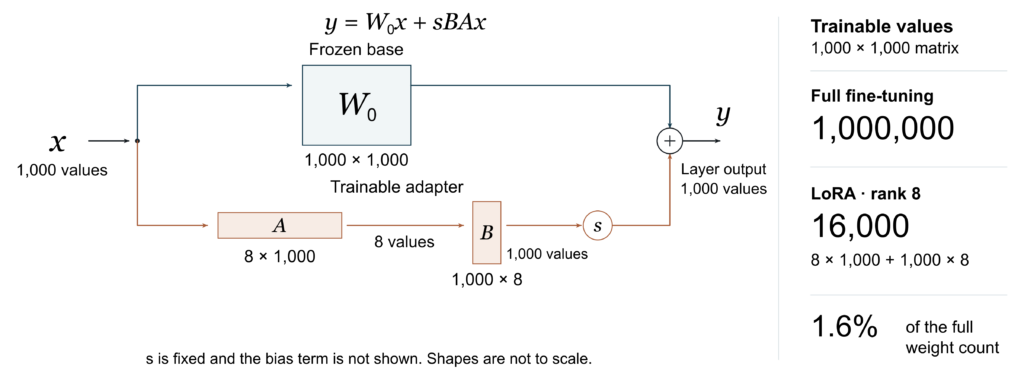
Abbildung 3. LoRA kombiniert eine „eingefrorene“ Transformation W₀ (die ursprünglichen, unveränderten Modellgewichte) mit einer trainierbaren Korrektur sBA. Für eine 1.000 × 1.000-Schicht mit Rang 8 enthält der Adapter 16.000 trainierbare Werte, was nur 1,6 % der ursprünglichen Gewichtsanzahl entspricht. Bei der regionalen Anpassung werden nur A und B verändert. Der Skalierungsfaktor s ist fest vorgegeben, und der Bias-Term wird nicht dargestellt. © FloodWaive
.
Wir haben außerdem eine verwandte Methode untersucht, die gewichtszerlegte Low-Rank-Anpassung (DoRA,). Bei DoRA werden die vortrainierten Gewichte des Modells in zwei Komponenten aufgeteilt: Größe und Richtung. Dabei wird die Größe separat aktualisiert, während auf die Richtung eine Low-Rank-Anpassung angewendet wird. Die Integration dieser Methoden erforderte Anpassungen an der bestehenden Modellarchitektur, weshalb wir unsere eigenen LoRA- und DoRA-Komponenten entwickelten. Ein früher Prototyp hatte gezeigt, dass Standard-Adapter-Software nicht direkt auf die Attention-Schichten des Modells angewendet werden konnte. Wir überprüften die mathematischen Grundlagen unserer Komponenten, insbesondere hinsichtlich der Platzierung der Adapter und der Parameter, die sich während der Anpassung ändern durften.
In den Vergleichen der Kooperationsgruppe näherten sich LoRA und DoRA der vollen Feinabstimmungsleistung an. Gleichzeitig benötigten sie weitaus weniger trainierbare Parameter. Ihre modulare Struktur vereinfacht zudem die Bereitstellung. Regionale Adapter können separat gespeichert und mit einer gemeinsamen Basis kombiniert werden, was Doppelarbeit zwischen regionalen Modellen reduziert.
Bewertung von Transfer und lokaler Verbesserung
Der Verwendungszweck eines Modells bestimmt, welche Daten bei der Bewertung aus dem Trainingsprozess ausgeklammert werden müssen. Ein Basismodell sollte auch in Regionen funktionieren, die es noch nie gesehen hat. Diese Übertragbarkeit wird an geografischen Gebieten getestet, die vom Training des Basismodells ausgeschlossen wurden. Die regionale Anpassung wirft eine andere Frage auf: Verbessert das angepasste Modell die Vorhersagen für Ereignisse in demselben Gelände, das nicht für die Feinabstimmung verwendet wurde? Abbildung 4 unterscheidet diese Formen der Generalisierung, d. h. die Fähigkeit des Modells, bei neuen, bisher unbekannten Daten gute Ergebnisse zu erzielen.
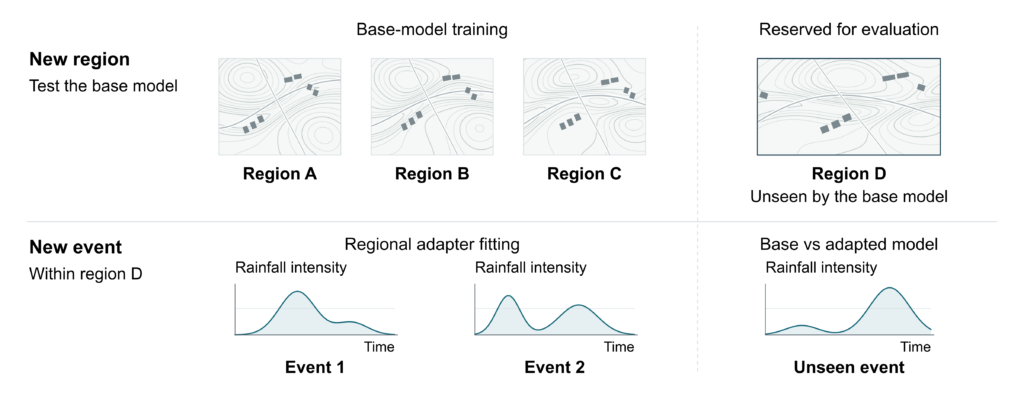
Abbildung 4. Die Generalisierungsfähigkeit sollte sowohl für neue Regionen als auch für neue Ereignisse getestet werden. In der Abbildung wird Region D vom Basistraining ausgeschlossen. Bei der Anpassung werden ausgewählte lokale Ereignisse herangezogen, wobei ein separates Ereignis für den Vergleich zwischen dem Basis- und dem angepassten Modell reserviert ist. © FloodWaive.
Bei der räumlichen Auswertung müssen auch die Merkmale berücksichtigt werden, die für die Entscheidungsfindung in der Praxis von Bedeutung sind. So kann beispielsweise eine hohe Übereinstimmung über weite Teile einer Karte hinweg mit einem kritischen Fehler im vorhergesagten Fließweg einhergehen. Ein solcher Fehler könnte dazu führen, dass die Behörden falsch einschätzen, ob eine Straße oder ein Gebäude gefährdet ist. Daher hilft die Untersuchung des Ausmaßes der Überschwemmung sowie der sich ändernden Wassertiefen und Strömungsmuster dabei, einen Gesamtgenauigkeitswert zu interpretieren. Die Wasserbilanz sorgt für eine zusätzliche physikalische Konsistenzprüfung, indem sie den Wasserzufluss, den Wasserabfluss und den Wasserbestand innerhalb des Gebiets in Beziehung setzt.
Effizientes Training mit operativer Vorhersage verbinden
Seit Mai 2025 nutzt die StädteRegion Aachen das mit FloodWaive entwickelte, KI-gestützte Hochwasser-Frühwarnsystem. Das System berechnet seine Hochwasserkarten mit DeepWaive. In einem solchen operativen Umfeld umfasst die Gesamtlaufzeit die Aufbereitung der Eingabedaten, die Ausführung des Modells selbst (Inferenz) und die Erstellung nutzbarer Hochwasserkarten. Durch die Beschleunigung der Berechnung bleibt Zeit, mehrere plausible Niederschlagsszenarien zu untersuchen. Außerdem können die prognostizierten Folgen aktualisiert werden, sobald sich die Vorhersage ändert.
Im Rahmen unserer Zusammenarbeit mit WestAI haben wir untersucht, welche Entwicklungsentscheidungen diesem Ziel dienen. Bei den untersuchten Konfigurationen ergaben die Trainingsvergleiche, dass bei etwa 500 Millionen Parametern das beste Gleichgewicht erreicht wurde. Die Datenexperimente und der separate Barrier-Test zeigten, dass nicht nur die Menge der Trainingsdaten, sondern auch die Bandbreite der darin abgedeckten Situationen eine Rolle spielt. In den Adaptionsexperimenten kamen LoRA- und DoRA-Adapter mit weitaus weniger trainierbaren Parametern fast an eine vollständige Feinabstimmung heran. Die zukünftige Entwicklung konzentriert sich daher darauf, die Situationen zu identifizieren, die zusätzliche Trainingsszenarien erfordern, und zu testen, ob sich die daraus resultierenden Verbesserungen auch auf unbekannte Ereignisse übertragen lassen.
Danksagung
Die Forschungskooperation nutzte von WestAI bereitgestellte Rechenressourcen.