Stellen Sie sich folgende Situation vor: Ein Patient in kritischem Zustand wird in ein Krankenhaus eingeliefert. Im Schockraum versuchen rund ein Dutzend Ärzt*innen und medizinische Fachkräfte, seinen Zustand zu stabilisieren. Dabei besprechen sie dringende Fragen und versuchen gleichzeitig, sich gegenseitig auf dem Laufenden zu halten. Selbst unter optimalen Bedingungen ist es schwierig, dabei den Überblick zu behalten – erst recht am Ende einer zwölfstündigen Schicht.
Als Entwicklungspartner von T-Systems haben wir ein agentisches System konzipiert und implementiert, das medizinisches Personal genau in dieser Situation unterstützen soll: den TraumaAgent. Er verfolgt den gesamten Behandlungsverlauf und stellt in Echtzeit eine strukturierte Übersicht über den Zustand des Patienten und die durchgeführten Behandlungsmaßnahmen bereit. So soll er Ärzt*innen dabei helfen, auch in extrem stressigen Situationen den Überblick zu behalten und zugleich die Dokumentation nach der Behandlung unterstützen.
Für den produktiven Einsatz ist es unerlässlich, dass ein solches System die geltenden Datenschutzbestimmungen erfüllt – schließlich verarbeitet es höchst sensible personenbezogene Daten. Gleichzeitig darf dies nicht zulasten der Genauigkeit und Leistungsfähigkeit des Systems passieren. Um ein Höchstmaß an Datenschutz zu gewährleisten, betreiben wir das System deshalb vollständig on-premises, also lokal vor Ort. Das bringt jedoch eine Reihe von Herausforderungen mit sich, die wir in diesem Blogbeitrag beschreiben. Wir hoffen, dass unsere Erfahrungen all jenen hilfreiche Anhaltspunkte bieten, die ebenfalls eine lokale Bereitstellung eines agentischen Systems in Betracht ziehen und abwägen müssen, was dabei für ihren jeweiligen Anwendungsfall zu beachten ist.
Zwei zentrale Backend-Komponenten ermöglichen dabei den Betrieb des TraumaAgenten: ein Modell zur automatischen Spracherkennung (Automatic Speech Recognition, ASR) und ein Large Language Model (LLM). Beide basieren auf der Transformer-Architektur und einige der in diesem Beitrag beschriebenen Herausforderungen gelten für beide Komponenten gleichermaßen. Wir konzentrieren uns im Folgenden jedoch vor allem auf das Large Language Model, das sämtliche textbasierten agentischen Workflows steuert.
Eine kurze Einführung in die LLM-Inferenz
Bevor wir ins Detail gehen, folgt zunächst eine kurze Einführung in die LLM-Inferenz (einen ausführlichen Überblick bietet z.B. dieser Artikel auf Huggingface).
Vereinfacht gesagt generiert ein LLM jeweils ein sogenanntes Token – also beispielsweise einen Teil eines Wortes. Im Durchschnitt besteht ein Wort aus etwa 1,3 Tokens. In einem Chatbot verarbeitet das LLM zunächst die Eingabe des Nutzers und erzeugt anschließend schrittweise weitere Tokens, aus denen sich die Antwort zusammensetzt.
Bei der Inferenz lassen sich daher zwei Phasen unterscheiden: die Verarbeitung des Prompts und die Generierung der Antwort. Die erste Phase ist vergleichsweise einfach umzusetzen: Die gesamte Sequenz der Prompt-Tokens kann parallel verarbeitet werden. GPUs, die für den Betrieb von LLMs eingesetzten Grafikprozessoren, sind für solche parallelen Berechnungen besonders gut geeignet.
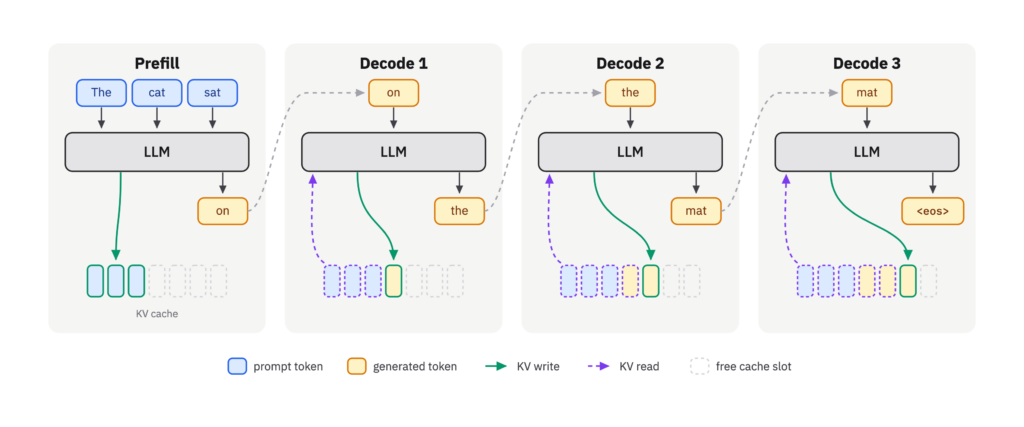
Die Antwortgenerierung lässt sich dagegen nicht auf dieselbe Weise parallelisieren, da jedes neu erzeugte Token von den zuvor generierten Tokens abhängt. Damit nicht für jedes neue Token sämtliche vorherigen Tokens erneut verarbeitet werden müssen, werden Zwischenergebnisse der Berechnungen im GPU-Speicher abgelegt. Dieses Verfahren wird als KV-Caching bezeichnet. Dadurch lässt sich die Token-Generierung erheblich beschleunigen. Gleichzeitig erfordert sie jedoch eine hohe Speicherbandbreite der GPU, da für jedes Token wiederholt auf den KV-Cache zugegriffen und in ihn geschrieben werden muss.
Von cloudbasierten LLMs zur lokalen Bereitstellung
Auf einem großen kommerziellen GPU-Server können beide Phasen schnell ausgeführt werden: Die Hardware ermöglicht sowohl eine schnelle Prompt-Verarbeitung als auch – dank hoher Speicherbandbreite – eine schnelle Token-Generierung.
Dank unseres Zugangs zur Open Telekom Cloud (OTC) konnten wir diese Leistungsfähigkeit nutzen, unser hochperformantes Agentensystem entwickeln und unter idealen Bedingungen erproben. Die Herausforderung des Datenschutzes blieb jedoch bestehen.
Über T-Systems erhielten wir Zugang zu NVIDIA DGX Spark-Systemen. NVIDIA bewirbt den DGX Spark als Desktop-Supercomputer. Das kompakte System basiert auf einem hochmodernen GPU-Chip mit 128 GB Speicher. Dadurch lassen sich auch größere Sprachmodelle mit hoher Geschwindigkeit betreiben, ohne dafür eine vollständige Server-Infrastruktur aufbauen zu müssen – theoretisch also ideal für unseren Anwendungsfall.
In der Praxis stießen wir jedoch auf zwei zentrale Herausforderungen:
- Ein noch nicht vollständig ausgereiftes Software-Ökosystem
- Eine begrenzte Speicherbandbreite
Das Software-Ökosystem
Als LLM haben wir uns für OpenAIs Open-Weight-Modell GPT-OSS-120b entschieden. Mit 120 Milliarden Parametern handelt es sich um ein mittelgroßes Modell, das grundsätzlich für Edge Deployment (die dezentrale Datenverarbeitung am Rande des Netzwerks) geeignet ist und gleichzeitig über starke Reasoning- und agentische Fähigkeiten verfügt.
Beim Betrieb in der OTC erwies sich das Modell für unser Agentensystem als sehr geeignet – unter anderem aufgrund des konfigurierbaren Reasoning Effort. Damit lässt sich festlegen, wie intensiv das Modell gewissermaßen „nachdenkt“, bevor es eine Antwort zurückgibt oder eine Aktion ausführt.
Ein weiterer besonders nützlicher Vorteil des Modells ist die native Gewichtsquantisierung auf MXFP4. Im Vergleich zu einem regulären Sprachmodell benötigt es dadurch nur etwa ein Viertel des GPU-Speichers und ermöglicht auf aktuellen GPU-Architekturen schnellere Berechnungen.
Ein reguläres 120B-Modell würde mindestens 240 GB Speicher benötigen, während dieses Modell mit rund 60 GB betrieben werden kann. Die GB10-GPU im DGX Spark ist daher grundsätzlich in der Lage, beide Vorteile zu nutzen.
An dieser Stelle stießen wir jedoch auf das erste Problem: NVIDIA stellt mit dem DGX Spark kompatible Versionen gängiger Inferenz-Frameworks bereit – in unserem Fall verwenden wir vLLM . Diese funktionieren zwar, sind jedoch noch nicht vollständig darauf optimiert, diese spezielle Form der Quantisierung auszunutzen.
Das Ergebnis: Sowohl die Prompt-Verarbeitung als auch die Token-Generierung sind langsamer, als sie theoretisch sein könnten. Für unseren Anwendungsfall ist das ein erheblicher Nachteil, denn niedrige Latenzen sind entscheidend dafür, dass das System in der Praxis einen Mehrwert bietet.
Allerdings gibt es Möglichkeiten, dieses Problem zu umgehen. Rund um den DGX Spark hat sich eine Community gebildet, die erhebliche Arbeit in stärker optimierte Versionen von Inferenz-Frameworks investiert. Ein gutes Beispiel dafür ist dieses hier auf GitHub, mit dem wir die Geschwindigkeit der Token-Generierung um 50 Prozent steigern konnten.
Die Speicherbandbreite
Während der GB10-Chip bei der Prompt-Verarbeitung eine hohe Leistung erreicht, verfügt der verwendete Speicher über eine deutlich geringere Bandbreite als der Speicher von Server-GPUs.
Wie oben beschrieben, wirkt sich dies insbesondere auf die Geschwindigkeit der Token-Generierung aus. Diesen Effekt konnten wir auch praktisch beobachten: Der von uns gemessene Durchsatz bei der Token-Generierung beträgt lediglich etwa ein Viertel dessen, was mit einer einzelnen Server-GPU erreicht werden kann.
Die Auswirkungen wurden unmittelbar deutlich, als wir unsere Anwendung im Simulations-Schockraum der Klinik in Köln-Merheim einsetzten: Informationen, die aus den Gesprächen der Ärzt*innen extrahiert wurden, erschienen zu spät auf dem Dashboard.
Um diese Latenz zu reduzieren, verringerten wir den Reasoning-Effort des Modells. Das Modell erzeugte dadurch weniger Tokens für seinen Reasoning-Prozess. Auf diese Weise konnten wir die Latenz wieder auf ein akzeptables Niveau senken – allerdings auf Kosten der Genauigkeit der auf dem Dashboard dargestellten Informationen.

Der Grund dafür liegt in der Art der Kommunikation im Schockraum: Relevante Informationen werden häufig nicht ausdrücklich ausgesprochen, sondern durch die intensive Verwendung von Fachsprache schwerer zugänglich gemacht oder bleiben schlicht implizit.
Eine weitere verbreitete Methode, mit begrenzter Speicherbandbreite umzugehen, besteht darin, auch den KV-Cache zu quantisieren. Die gespeicherten Zwischenergebnisse werden dabei in einem Datentyp mit geringerer Präzision abgelegt. Dadurch können die Daten für jede verarbeitete Sequenz schneller gelesen und geschrieben werden.
Theoretisch kann dies allerdings zulasten der Qualität gehen, da es sich um eine verlustbehaftete Quantisierung handelt. In unserem Fall entschieden wir uns für FP8 als Datentyp und beobachteten dabei lediglich einen zu vernachlässigenden Qualitätsverlust.
Der Einsatz mehrerer DGX Sparks
Zusätzlich zu den beschriebenen Optimierungen und Workarounds besteht grundsätzlich die Möglichkeit, zwei DGX-Spark-Systeme miteinander zu verbinden. Dadurch kann der verfügbare GPU-Speicher effektiv gemeinsam genutzt und die Berechnung auf beide GPUs verteilt werden.
Die zuvor beschriebenen Einschränkungen gelten allerdings weiterhin. In unserem Szenario mit einzelnen, nicht parallel ausgeführten Anfragen führt die Verdopplung der Gerätezahl daher keineswegs zu einer Halbierung der Latenz. Tatsächlich steigt der Durchsatz bei der Token-Generierung lediglich um etwa 30 Prozent.¹
Das ist zwar kein grundlegender Leistungssprung, sorgt aber dennoch für eine spürbare Verbesserung.
Übertragung auf allgemeinere Anwendungsfälle
Ein solches Cluster-Setup bietet darüber hinaus weitere Vorteile. Um diese zu verdeutlichen, lohnt sich ein Blick auf allgemeinere Anwendungsfälle, bei denen die Latenz möglicherweise weniger kritisch ist, während die Fähigkeit des Modells, sehr komplexe Aufgaben zu lösen, eine größere Rolle spielt.
Denkbar sind beispielsweise ein Coding-Assistent für vertrauliche Codebasen oder ein umfangreicheres agentisches System zur Analyse sensibler Verträge – jeweils ebenfalls unter hohen Datenschutzanforderungen.
Hinzu kommt, dass solche Anwendungen häufig nicht nur von einer einzelnen Person, sondern von einem ganzen Team genutzt werden. Dadurch verändern sich auch die Anforderungen an die Hardware.
Im Vergleich zum Echtzeit-Single-User-Szenario des TraumaAgent bietet ein Cluster aus mehreren DGX-Spark-Systemen gerade für solche Anforderungen Vorteile.
Zum einen steht doppelt so viel nutzbarer Speicher zur Verfügung. Dadurch können Modelle mit mehr Parametern und potenziell größerer Leistungsfähigkeit betrieben werden, beispielsweise das verbreitete DeepSeek-V4-Flash mit 284 Milliarden Parametern.
Zum anderen ermöglicht mehr Arbeitsspeicher die Speicherung eines größeren KV-Caches. Da jeder Konversations-Thread mit dem Modell zu einer KV-Cache-Auslastung führt, die proportional zur Anzahl der Token in der Konversation ist, bedeutet dies, dass mehr Nutze*innen gleichzeitig mit einer akzeptablen Geschwindigkeit bedient werden können.
Ganz grundsätzlich gibt es verschiedene Möglichkeiten, LLMs vollständig lokal zu betreiben.
Eine Option ist eine klassische Server-Infrastruktur on-premises. Diese bietet deutlich höhere Leistungsreserven, geht jedoch mit wesentlich höheren Kosten einher und erfordert zusätzlichen Platz, Kühlung, Wartung und weitere Infrastruktur.
Alternativ kommen Desktop-Systeme für KI-Anwendungen infrage. Apple Mac mini oder Geräte auf Basis von AMD Strix Halo sind beispielsweise verbreitete Alternativen zum DGX Spark.
Jede dieser Optionen bringt Vor- und Nachteile mit sich. Wir hoffen, dass dieser Beitrag einige der möglichen Einschränkungen und Herausforderungen verdeutlicht und Leser*innen damit dabei unterstützt, eine fundierte Entscheidung für ihren jeweiligen Anwendungsfall zu treffen.
Fazit
Noch vor ein oder zwei Jahren wäre der lokale Betrieb komplexer LLM-basierter Anwendungen ohne hohe Anfangsinvestitionen in KI-Hardware kaum denkbar gewesen. Heute ist dies durchaus möglich.
Da Open-Weight-LLMs immer leistungsfähiger und kompakte KI-Hardware zunehmend leistungsstärker werden, dürfte die Einstiegshürde weiter sinken.
Der Wechsel von der Cloud auf Edge-Hardware ist derzeit allerdings noch keineswegs vollständig unkompliziert und mit verschiedenen Einschränkungen verbunden. Unser spezieller, aber zugleich hochrelevanter Anwendungsfall zeigt, dass diese Einschränkungen ganz konkrete praktische Auswirkungen haben – aber auch, dass sich viele davon durch gezielte Maßnahmen abmildern lassen.