KI: Bahnbrechende Innovation oder einfach nur Glück?
Künstliche Intelligenz scheint überall zu sein. Viele setzen auf die Technologie, weil sie an ihr Potenzial glauben, eine Vielzahl moderner Probleme zu lösen. Gleichzeitig behaupten zahlreiche Unternehmen, ihre Produkte seien KI-basiert, nutzten KI oder seien mithilfe von KI entstanden. Auch die Medien tragen zur starken Präsenz des Themas im öffentlichen Diskurs bei – mitunter durch reißerische oder fehlerhafte Berichterstattung.
Andere sehen KI deutlich kritischer und verbinden mit ihr Risiken, die von steigender Arbeitslosigkeit bis hin zu einer Bedrohung für die Menschheit selbst reichen. Wie sind wir an diesen Punkt gelangt?
Um das zu verstehen, lohnt sich ein Blick darauf, woher der Begriff „KI“ stammt – und was er eigentlich bedeutet.
Eine kurze Geschichte der KI
Von mythischen Erzählungen einmal abgesehen, wird der Begriff „Künstliche Intelligenz“ gemeinhin auf das „Dartmouth Summer Research Project on Artificial Intelligence“ von 1956 zurückgeführt. Wichtige Entwicklungen hatte es jedoch schon zuvor gegeben.
Das McCulloch-Pitts-Neuron, das Walter Pitts und Warren McCulloch 1943 vorstellten, beschrieb das Konzept eines künstlichen Neurons, das binäre Informationen verarbeitet, und legte damit wichtige Grundlagen für moderne neuronale Netze.
1950 stellte Alan Turing die Idee vor, die später als Turing-Test bekannt wurde: Eine Maschine könne vernünftigerweise als intelligent gelten, wenn sie ein Gespräch so führen könne, dass ein Mensch nicht zuverlässig unterscheiden könne, ob er mit einem anderen Menschen oder mit einer Maschine kommuniziert.
KI zog damals erhebliche Aufmerksamkeit auf sich. Forschungsinstitute wurden gegründet und neue Fördermöglichkeiten geschaffen. Als Forschende die hohen Erwartungen an die Technologie jedoch nicht erfüllen konnten, ging die öffentliche Begeisterung in den 1970er-Jahren stark zurück. Die Folge war der heute sogenannte erste KI-Winter, der insbesondere durch Kürzungen der Forschungsförderung geprägt war.
In den 1980er-Jahren kehrte das Interesse zurück, diesmal vor allem in Form sogenannter „Expertensysteme“. Diese Systeme ahmen menschliche Entscheidungsprozesse mithilfe algorithmischer Wenn-dann-Regeln nach. Fortschritte in der Computerhardware machten sie nicht nur für die Forschung, sondern auch für die Industrie attraktiv. Ihre praktischen Einsatzmöglichkeiten blieben jedoch begrenzt, was zum zweiten KI-Winter in den 1990er-Jahren beitrug.
Die Förderung ging erneut zurück – doch die Forschung ging weiter.
In den 2000er- und 2010er-Jahren machte das Maschinelle Lernen erhebliche Fortschritte, die zu einem großen Teil durch neue technologische Möglichkeiten ermöglicht wurden. Die Modelle wurden zunehmend leistungsfähiger, insbesondere in Bereichen wie Convolutional Neural Networks zur Bildverarbeitung. Mit der Zeit führten Entwicklungen unter anderem in der natürlichen Sprachverarbeitung und der Computer Vision dazu, dass Anwendungen wie optische Zeichenerkennung und Objekterkennung immer leistungsfähiger wurden.
Ein großer Teil dieser Grundlagenarbeit erhielt allerdings deutlich weniger öffentliche Aufmerksamkeit als heutige KI-Systeme. Das änderte sich mit dem Aufstieg großer Sprachmodelle und dem neuen öffentlichen Interesse an generativer KI grundlegend. Seitdem ist KI kaum noch zu übersehen.
Aber was genau ist eigentlich KI?
Es gibt keine allgemein anerkannte Definition von Künstlicher Intelligenz. Gängige Beschreibungen beziehen sich häufig auf Systeme, die Aufgaben erfüllen, die mit bestimmten Aspekten menschlicher Intelligenz in Verbindung gebracht werden.
Der Begriff ist entsprechend weit gefasst. Er dient als Oberbegriff für verschiedene Teilgebiete, zu deren wichtigsten das Maschinelle Lernen (ML) gehört. Beim Maschinellen Lernen wird ein Modell anhand von Daten darauf trainiert, Vorhersagen zu treffen oder Inhalte zu erzeugen. ML umfasst wiederum Ansätze wie Deep Learning, das auf mehrschichtigen neuronalen Netzen basiert.
Neuronale Netze bestehen aus mehreren Schichten, die Eingaben auf vorab festgelegte Weise aufnehmen und verarbeiten. In der Computer Vision kann beispielsweise eine sogenannte Convolutional Layer relevante Merkmale in einem Bild erkennen, etwa Kanten oder Formen. Am Ende des Modells erzeugt ein Output-Layer eine Vorhersage – zum Beispiel eine Schätzung des Alters einer Person anhand eines Fotos.
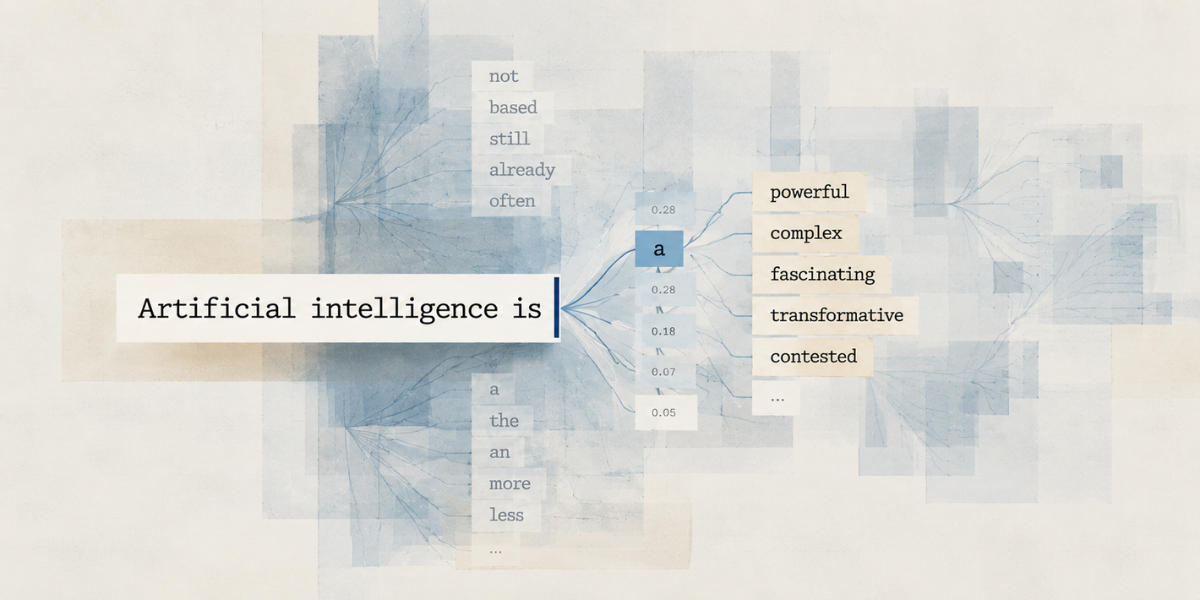
Zu den komplexeren Deep-Learning-Modellen gehören Transformer, die die Grundlage heutiger Large Language Models (LLMs) wie GPT, Claude oder Gemini bilden. Vereinfacht gesagt erzeugt ein LLM Text, indem es vorhersagt, welches Token mit der höchsten Wahrscheinlichkeit auf die vorhergehenden folgt.
Dafür müssen solche Modelle mit enormen Datenmengen trainiert werden. Während die grundlegende Struktur des Modells von den Entwickler*innen festgelegt wird, werden die einzelnen numerischen Parameter, die bestimmen, wie Informationen verarbeitet werden, während des Trainings gelernt.
Nehmen wir die Bilderkennung als vereinfachtes Beispiel. Ein Modell trifft zunächst Vorhersagen, die kaum besser als bloße Vermutungen sein können. Indem es diese Vorhersagen mit dem erwarteten Ergebnis vergleicht, passt es seine internen „Gewichte“ an – numerische Werte, die beeinflussen, welche Merkmale für eine bestimmte Vorhersage stärker oder schwächer ins Gewicht fallen.
Diese Fähigkeit, Parameter auf Grundlage von Trainingsdaten anzupassen, ist der Grund, warum wir von „Lernen“ sprechen. Ist ein Modell einmal trainiert, kann es das Gelernte häufig auf neue, ähnliche Eingaben anwenden. Vortrainierte Modelle können Fähigkeiten daher auf eine Vielzahl von Aufgaben übertragen.
Im allgemeinen Sprachgebrauch werden solche Systeme meist unter dem Oberbegriff „Künstliche Intelligenz“ zusammengefasst. Das ist nicht unbedingt falsch, aber ungenau. Und diese Unschärfe ist relevant, denn solche Systeme werden häufig so wahrgenommen, als kämen ihre Prozesse menschlichem Denken deutlich näher, als es ihre zugrunde liegenden Mechanismen tatsächlich nahelegen.
Das führt uns zur zentralen These dieses Beitrags:
LLMs sind eine hochentwickelte Simulation menschlicher Intelligenz. Nicht mehr und nicht weniger.
Das bekannte Gedankenexperiment des „Chinese Room“ veranschaulicht diesen Unterschied besonders gut. In einer Arbeit aus dem Jahr 1980 stellte der Philosoph John Searle ein System vor, das scheinbar Chinesisch versteht, indem es Regeln befolgt – ohne die Sprache tatsächlich zu verstehen.
Stellen wir uns eine Person vor, die kein Chinesisch spricht und in einem Raum sitzt. Sie erhält chinesische Schriftzeichen, schlägt in detaillierten Anweisungen nach, welche Zeichen sie zurückgeben soll, und erzeugt so eine passende Antwort. Für jemanden außerhalb des Raums könnten diese Antworten nicht von denen einer Person zu unterscheiden sein, die fließend Chinesisch spricht. Die Person im Raum versteht die Sprache jedoch weiterhin nicht. Sie manipuliert Symbole anhand von Regeln.
Searle nutzte dieses Gedankenexperiment, um zu argumentieren, dass die erfolgreiche Verarbeitung von Symbolen nicht zwangsläufig echtes Verständnis bedeutet. Unabhängig davon, ob man seiner weitergehenden philosophischen Schlussfolgerung zustimmt, ist diese Unterscheidung für die Art und Weise, wie wir über moderne KI sprechen, hoch relevant.
Warum glauben manche Menschen, KI sei intelligent?
Wenn Deep-Learning-Modelle letztlich Vorhersagesysteme sind, warum erscheinen sie dann so vielen Menschen intelligent?
Dafür gibt es drei zentrale Gründe.
Erstens kommunizieren Chatbots – anders als die meisten früheren Technologien – auf eine für uns zutiefst vertraute Weise: durch Sprache. Kommunikation ist zentral für menschliche Interaktion, und moderne Sprachschnittstellen lassen diese Systeme noch menschlicher erscheinen. Manche Nutzer*innen entwickeln dadurch sogar eine emotionale Bindung zu ihnen.
Zweitens ist die KI-Forschung außerordentlich komplex. Viele moderne Modelle funktionieren als „Black Boxes“, deren interne Prozesse insbesondere für Nicht-Fachleute schwer nachzuvollziehen sind. Und natürlich steckt das Wort „Intelligenz“ unmittelbar im Begriff „Künstliche Intelligenz“. Es überrascht daher kaum, dass Menschen annehmen, diese Systeme verfügten über etwas, das menschlicher Intelligenz ähnelt.
Der dritte Grund ist vielleicht der wichtigste – und zugleich die zentrale Inspiration für diesen Beitrag: „KI“ ist ein hervorragender Marketingbegriff.
Er ist weit gefasst, wirkungsvoll und angenehm vage. Er lässt sich auf eine Vielzahl von Technologien anwenden, ohne dass präzise erklärt werden muss, wie diese tatsächlich funktionieren.
Diese fehlende Klarheit trägt auch zur unsachgemäßen Nutzung von LLMs bei. Und dabei ist die mangelnde Transparenz rund um Trainingsdaten oder systemseitige Anweisungen, die beeinflussen, wie ein Modell antwortet, noch gar nicht berücksichtigt.
Aus unternehmerischer Sicht ist der Wunsch nachvollziehbar, ein attraktives Produkt zu vermarkten. Aus Forschungsperspektive halte ich jedoch mehr Präzision für notwendig. Auch Forschende selbst tragen Verantwortung. In den vergangenen Jahren sind erhebliche Fördermittel in Arbeiten geflossen, die als KI-bezogen bezeichnet werden. Das schafft nur wenige Anreize, den vorherrschenden Hype rund um das Forschungsfeld kritisch zu hinterfragen.
Doch genau das sollte Teil unserer Verantwortung als Expert*innen sein: klar zu erklären, was KI kann – und was nicht.
Wo stehen wir also?
KI-Forschung ist ein faszinierendes Feld und wird hoffentlich auch weiterhin intensiv und verantwortungsvoll betrieben. Ihre Geschichte zeigt bereits, dass die zugrunde liegenden Technologien von langfristiger Bedeutung sind.
Doch je stärker KI Teil unseres Alltags wird, desto wichtiger ist auch ein besseres gesellschaftliches Verständnis davon, was diese Systeme sind – und was sie nicht sind.
In Zeiten zunehmender Desinformation und Unsicherheit ist es besonders wichtig zu verstehen, dass LLMs fehleranfällig sind und ihre Antworten nicht automatisch als objektiv oder wahr angenommen werden können. Ihre Ausgaben entstehen durch statistische Vorhersagen. Sie besitzen kein Bewusstsein und sind auch nicht allwissend.
Das mag ernüchternd klingen. Zugleich kann es beruhigend sein.
Menschen bleiben unverzichtbar. Und viele dystopische Vorstellungen rund um KI beruhen darauf, diesen Systemen Fähigkeiten zuzuschreiben, über die sie schlicht nicht verfügen.
Wir sollten LLMs daher als das betrachten, was sie sind: leistungsfähige Werkzeuge, die bei angemessenem Einsatz von enormem Nutzen sein können.
Doch vorerst sind sie genau das – eine hochentwickelte Simulation von Intelligenz.