Offene Sprachmodelle haben sich in bemerkenswertem Tempo weiterentwickelt und inzwischen gibt es ein breites Ökosystem leistungsfähiger Modelle zur Auswahl. Wer jedoch vor der Entscheidung steht, welches Modell tatsächlich zum Einsatz kommt, stößt nach wie vor auf drei auffällige Lücken. Die erste Lücke betrifft die Transparenz: Die meisten Veröffentlichungen liefern weiterhin nur die Gewichte, nicht aber die Daten, den Code oder die Entscheidungen, die nötig wären, um sie zu reproduzieren oder zu überprüfen. Die zweite betrifft die Sprache: Allgemeine mehrsprachige Modelle sind entweder stark auf das Englische ausgerichtet oder verteilen ihre Kapazität über Dutzende Sprachen. Deutsch bleibt dabei, gemessen an seinem wirtschaftlichen und wissenschaftlichen Gewicht, unterrepräsentiert. Die dritte Lücke betrifft die Inferenzkosten: Erst wenn Inferenz-Effizienz und Kosten zusammengedacht werden, lässt sich ein leistungsfähiges Modell im großen Maßstab wirtschaftlich betreiben.
Mit Soofi S 30B-A3B haben wir uns vorgenommen, diese drei Lücken durch eine gemeinsame, institutionsübergreifende Initiative zu schließen. Soofi S ist ein souveränes, als Open Source konzipiertes Basismodell für Deutsch und Englisch. Es wird von einem Konsortium deutscher Forschungseinrichtungen, darunter das Lamarr Institut, Fraunhofer IAIS, das DFKI, die TU Darmstadt, hessian.AI, ellamind, das L3S Research Center und die Universität Würzburg entwickelt. Das Projekt wird durch den KI-Bundesverband koordiniert und durch das Bundesministerium für Wirtschaft und Energie (BMWE) gefördert. In diesem Blogbeitrag werfen wir einen genaueren Blick auf die Architektur, das Trainingsrezept und die Evaluationsergebnisse – und erklären, warum Transparenz für uns ebenso wichtig wie das Modell selbst ist.
Eine Architektur, gebaut für effiziente Inferenz
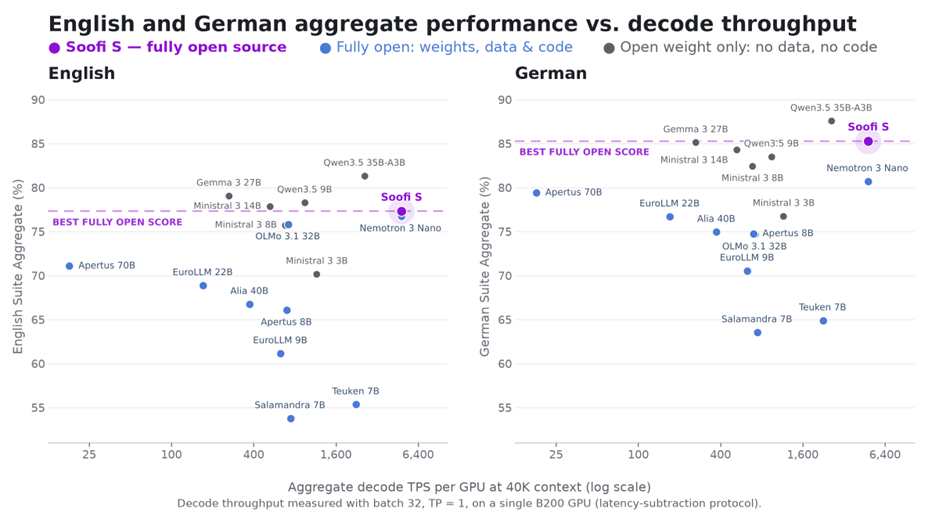
Die Zahl der aktiven Parameter ist nur ein Näherungswert dafür, was der Betrieb eines Modells tatsächlich kostet. In der Produktion ist die Leistung in Wahrheit durch die Speichergeschwindigkeit begrenzt: Für jedes generierte Token müssen die aktiven Modellgewichte und der Attention-Cache jeder Sequenz im Batch neu gelesen werden. Wachsen die Kontexte auf Zehn- oder Hunderttausende von Tokens, dominiert irgendwann dieser Key-Value-Cache (KV-Cache) und dichte Modelle mit voller Attention werden entsprechend langsamer.
Genau für dieses Einsatzszenario ist Soofi S ausgelegt. Das Modell übernimmt die offen publizierte Referenzarchitektur von Nemotron 3 Nano: ein Netzwerk mit 52 Schichten, in dem sich 23 Mamba-2-Schichten und 23 granulare MoE-Schichten abwechseln. Insgesamt umfasst das Modell rund 31,6 Milliarden Parameter, aktiviert pro Token aber nur etwa 3,2 Milliarden – die Kapazität eines 30B-Netzwerks zu den Inferenzkosten eines 3B-Modells. Da nur 6 der 52 Schichten einen KV-Cache führen und die Mamba-2-Schichten einen rekurrenten Zustand fester Größe aufweisen, bleibt der Speicherbedarf pro Sequenz klein und nahezu konstant, auch wenn der Kontext wächst.
Wir haben uns angesichts der Kürze der Zeit bewusst dafür entschieden, eine etablierte, offen spezifizierte Architektur wiederzuverwenden. Das Modell lässt sich so vom ersten Tag an in ausgereiften Entwicklungsumgebungen betreiben, und das architektonisch identische Nemotron 3 Nano dient als Referenzwert, an dem sich der Effekt unseres deutsch-englischen Datenrezepts isoliert messen lässt. Zugleich bietet Nemotron 3 Nano eine bewährte, hoch effiziente Grundlage für Langkontext-Inferenz in kurzer Zeit. Parallel dazu erforschen wir aktiv weitere Modellarchitekturen, die künftig noch stärker auf souveräne europäische Anforderungen zugeschnitten sein können.
Trainiert auf souveräner europäischer Infrastruktur
Soofi S wurde auf der Industrial AI Cloud der Deutschen Telekom in München trainiert, die gemeinsam mit NVIDIA aufgebaut und im Februar 2026 in Betrieb genommen wurde. Wir nutzten bis zu 512 NVIDIA-B200-GPUs – 64 DGX-B200-Knoten mit je acht GPUs – über rund 253.000 GPU-Stunden zwischen dem 24. März und dem 13. Mai 2026. Damit war Soofi S einer der ersten großen Trainings-Runs auf dieser neuen souveränen Infrastruktur im HPC-Maßstab.
Dass das Training auf deutschem Boden stattfand – unter europäischen Betriebs- und Datenschutzanforderungen statt auf außereuropäischer Hyperscale-Rechenleistung, gehört für uns zum Kern eines souveränen Modells. Das Münchner Rechenzentrum wird vollständig mit erneuerbarer Energie betrieben, mit Wasser aus dem nahegelegenen Eisbach gekühlt und ist in ein Abwärmekonzept eingebunden, das den umliegenden Tucherpark mitversorgt.
Ein Datencurriculum mit Deutsch im Fokus – vollständig dokumentiert
Soofi S wurde auf rund 27 Billionen Tokens vortrainiert, nach einem dreiphasigen Warmup–Stable–Decay-Curriculum: etwa 20 Billionen Tokens für das Pretraining, rund 6,6 Billionen Tokens für die Annealing-Phase und eine abschließende Langkontext-Phase, die das nutzbare Kontextfenster auf eine Million Tokens erweitert. Deutsch wurde dabei gezielt hochgewichtet: auf 7,2 % der Stable-Phase und 15,3 % der Annealing-Mischung – mehr als das Dreifache des mehrsprachigen Anteils im Referenzrezept. Das Ziel war ein echter Deutsch-Englisch-Champion statt eines dünn gestreuten mehrsprachigen Modells.
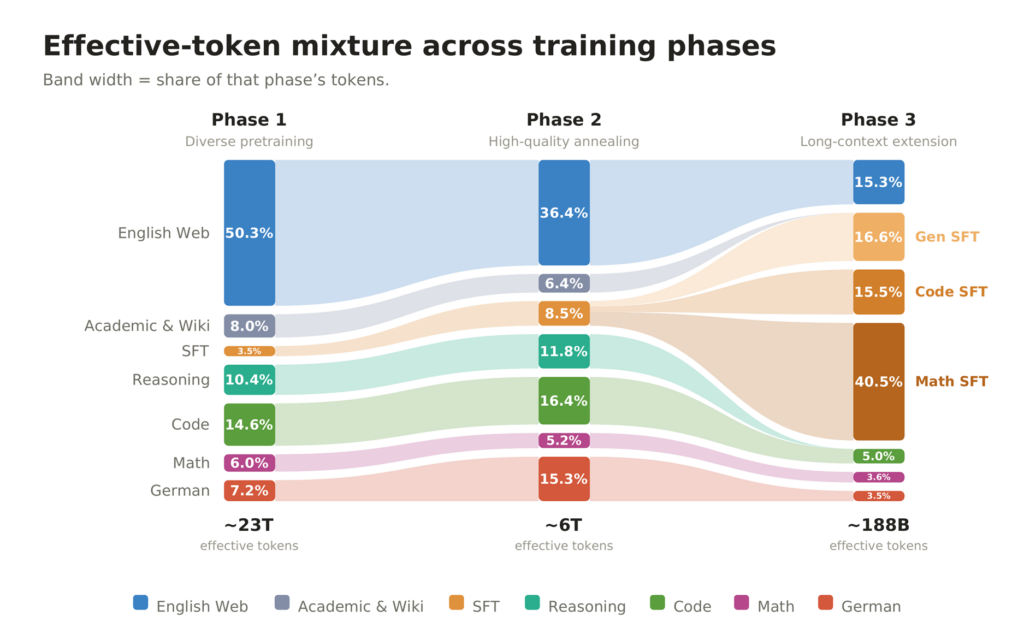
Genauso wichtig wie die Trainingsdaten ist uns eine lückenlose Dokumentation. Der Soofi S Pretraining Tech Report wird zusammen mit den vollständigen Korpusstatistiken für alle drei Pretraining-Phasen veröffentlicht – einschließlich der Quellen (auch derer, die wir geprüft und wegen schwacher Ergebnisse bewusst ausgeschlossen haben), mit Token-Abrechnung pro Quelle und pro Sprache. Wir veröffentlichen den kompletten Learning-Rate-Schedule, den Optimizer, jeden Hyperparameter und die Token-Budgets pro Phase.
Wie schlägt sich Soofi S?
Wir haben Soofi S gegen 15 offene Basismodelle evaluiert – mit einer gemeinsamen lm-evaluation-harness-Pipeline, identischen Prompts, Few-Shot-Konfigurationen und Task-Einstellungen, über die Bereiche Code, Mathematik, Wissen, Reasoning, Naturwissenschaften, Leseverständnis und deutsche Sprachbeherrschung hinweg. Den Vergleich teilen wir in zwei Gruppen: vollständig quelloffene Modelle, die wie Soofi S auch Daten und Code veröffentlichen (Alia 40B, EuroLLM 22B, Apertus 70B und Olmo 3 32B), und größere Open-Weight-Modelle, die nur ihre Gewichte freigeben (Qwen3.5 35B-A3B, Ministral 3 14B und Gemma 3 27B).
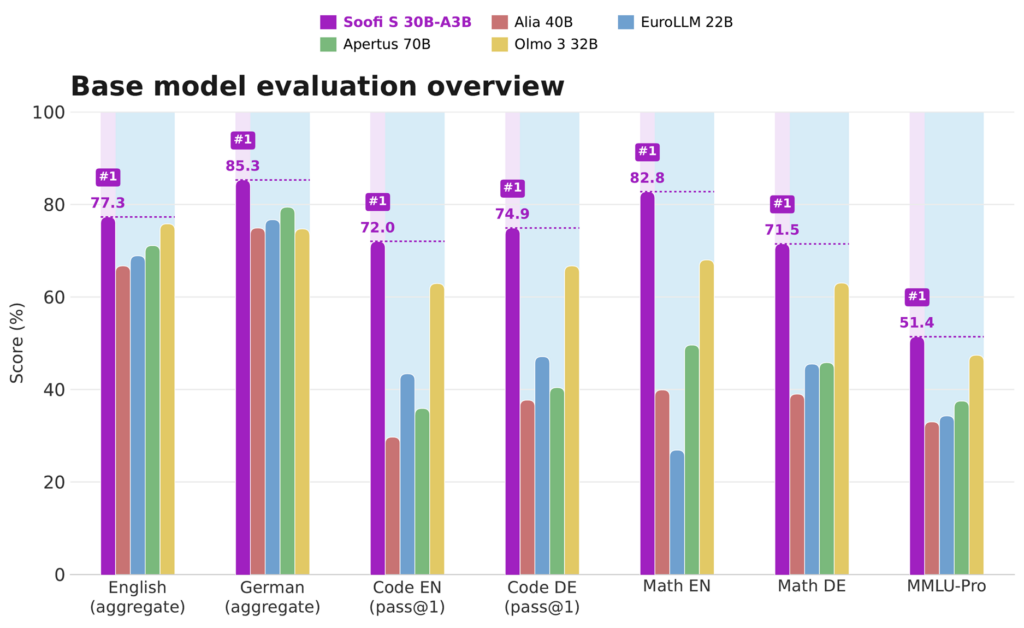
Unter den vollständig quelloffenen Modellen ist schneidet Soofi S in unserem Vergleich insgesamt am besten ab (Stand: 11. Juli 2026). Es erreicht das höchste englische Aggregat (77,3 – 1,5 Punkte vor Olmo 3 32B) und das höchste deutsche Aggregat (85,3 – 5,9 Punkte vor Apertus 70B), und das, obwohl es pro Token nur 3 Milliarden Parameter aktiviert, während die Baselines bis zu 70 Milliarden mitbringen. Die größten Abstände zeigen sich bei den deutschen und den technischen Benchmarks. Gegen die deutlich größeren Open-Weight-Modelle liegt Soofi S zwar nicht bei jedem Aggregat vorn, kann sich jedoch problemlos mit Modellen zwischen 14 und 27 Milliarden Parametern messen und übertrifft sein architektonisches Pendant Nemotron 3 Nano um 0,6 Punkte im Englischen und 4,6 Punkte im Deutschen, womit sich der Effekt unseres Datenrezepts isolieren lässt. Über alle 16 Modelle der Studie hinweg erzielt Soofi S die besten englischen und deutschen Code-Aggregate.
Starke Deutschfähigkeiten
Bei den deutschen Ergebnissen hebt sich Soofi S am deutlichsten ab. Im Vergleich zu allen anderen europäischen souveränen Baselines in unserer Studie — einschließlich Modellen mit einer Größenordnung mehr aktiven Parametern — erreicht oder übertrifft Soofi S sie in jedem deutschen Benchmark der Suite, häufig um 10 bis 30 Punkte.
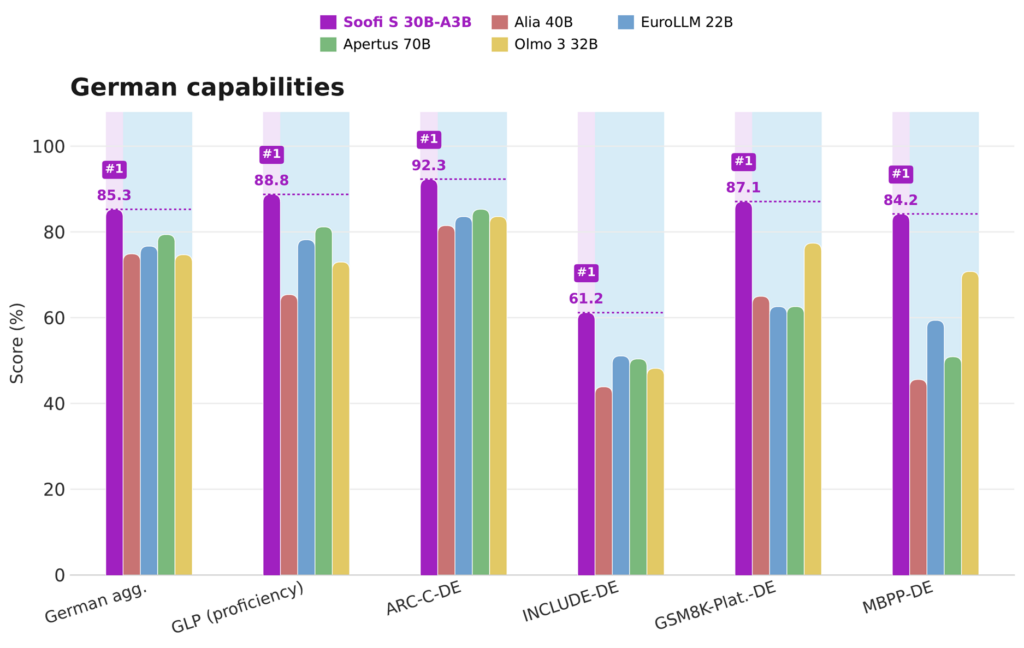
Konkret führt Soofi S den Open-Source-Vergleich beim deutschen Aggregat (+5,9), bei Deutschkompetenz (+7,6), deutschem Schlussfolgern auf ARC-Challenge-DE (+7,0), dem Wissensbenchmark INCLUDE-DE (+10,1), deutscher Grundschulmathematik auf GSM8K-Platinum-DE (+9,7) und deutscher Codegenerierung auf MBPP-DE (+13,4) an. Nach unserem Kenntnisstand ist Soofi S damit unter den bewerteten Modellen das leistungsstärkste offene deutsche Basismodell in seiner Inferenzkostenklasse.
Effizienter Kontext über lange Dokumente
Unser architektonisches Konzept zahlt sich besonders bei der Effizienz im Betrieb aus. Da nur 6 von 52 Schichten einen KV-Cache führen, hat Soofi S einen zusätzlichen Attention-Cache-Bedarf von nur etwa 6 KB pro Token und Sequenz, also 11- bis 53-mal kleiner als bei anderen dichten Modellen in unserem Vergleich. Bei einem Kontext von 40K Tokens und Batch-Größe 32 erreicht Soofi S eine gemessene aggregierte Decode-Rate von 4,82k Tokens pro Sekunde und GPU, rund 9-mal höher als ein dichtes 14B-Modell, während alle Gewichte und 32 Sequenzzustände auf eine einzelne GPU passen.
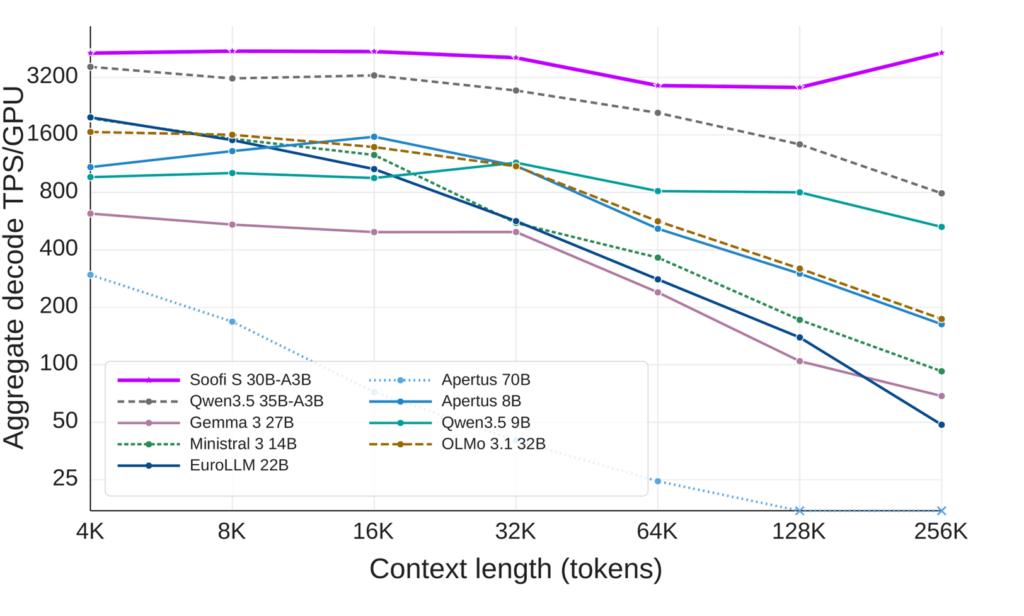
Entscheidend ist, dass dieser Vorteil mit zunehmender Kontextlänge größer wird. Der Durchsatz anderer Modelle sinkt, sobald KV-Cache-Lesezugriffe das Decoding dominieren, während Soofi S von 4K bis 256K Tokens nahezu konstant bleibt. Dasselbe gilt für die Zeit bis zum ersten Token: Bei einem Kontext von 256K verarbeitet Soofi S den Prompt schneller als jede von uns gemessene Baseline. Das ist der strukturelle Vorteil, der sich genau in dem Szenario verstärkt, das in der Produktion am wichtigsten ist: langer Kontext und hohe parallele Auslastung.
Offenlegung zur Kontamination
Wie andere offene Projekte (z. B. OLMo) trainieren wir mit umformulierten Übungsfragen aus bekannten Benchmarks: Probeprüfungen, nicht der eigentliche Test, damit sich das Modell mit den Aufgabenformaten vertraut machen kann, auf die es später getestet wird. Diese stammen aus Trainings-Splits, die normalerweise getrennt von den für die Evaluation verwendeten Test-Splits veröffentlicht werden. Für GPQA und GPQA Diamond gibt es keine solche Trennung: Der vollständige Evaluationssatz wird als einzelner Split veröffentlicht, auf Hugging Face mit „Train“ gekennzeichnet. Prüfungsfragen gelangten daher in den Trainingsdatensatz und von dort in unsere Daten. Community-Mitglieder, die den veröffentlichten QA-Base-Datensatz durchgesehen haben, stellten dies kurz nach der Veröffentlichung fest und wir haben dies anhand unserer Konstruktionspipeline bestätigt.
Ein vollständiges Audit des Datensatzes ergab insgesamt vier betroffene Benchmarks: GPQA, TruthfulQA, BLiMP und die Inverse-Scaling-Aufgaben. Nur GPQA ist Teil unserer Evaluationssuite, aber wir nennen alle vier, damit darauf erzielte Werte nicht mit echter Modellfähigkeit verwechselt werden. Wir haben GPQA Diamond und seine deutsche Variante aus allen Tabellen und Abbildungen entfernt und die englischen und deutschen Aggregate neu berechnet, sodass die Vergleiche fair bleiben und die oben genannten Rangfolgen unverändert sind. Eine korrigierte Datensatzveröffentlichung begleitet diese Revision.
Transparenz als Prinzip
Wir sind überzeugt, dass die Art und Weise, wie ein Modell veröffentlicht wird, Teil seines wissenschaftlichen Beitrags ist. Soofi S wird unter sehr permissiven Open-Access-Bedingungen veröffentlicht: die Modellgewichte, ausgewählte Checkpoints des Trainings, die vollständige Datenbilanz pro Quelle, alle Hyperparameter sowie der komplette Trainings- und Evaluationscode. Unser Ziel ist es, das offene Ökosystem einen Schritt weiterzubringen — von Open-Weight hin zu wirklich Open-Source — und eine reproduzierbare Vorlage für andere anzubieten, die leistungsfähige, effiziente und souveräne Basismodelle entwickeln möchten.
Für die Zukunft planen wir, Soofi S entlang dreier Achsen weiterzuentwickeln: offenes Post-Training für Instruction-Following- und Reasoning-Varianten, verbesserte deutsche Benchmarks sowie die weitere Skalierung der hochwertigen deutschen Datenpipeline, die diese Veröffentlichung als zentralen Engpass für weitere Fortschritte identifiziert hat. Wir laden die Forschungsgemeinschaft ein, auf dieser Arbeit aufzubauen, sie kritisch zu prüfen und weiterzuentwickeln.
Beta-Testing & Community-Zugang
Vor der Veröffentlichung wird Soofi S zunächst in einer geschlossenen Beta im Rahmen der IPCEI-CIS/8ra-Initiative getestet, ein europäisches Vorhaben mit über 100 Partnern aus Industrie, Mittelstand und Forschung in 12 EU-Staaten. Dieser Schritt soll helfen, Rückmeldungen zu Qualität, Sicherheit, Infrastrukturintegration und praktischer Nutzbarkeit unter realistischen Bedingungen zu sammeln.
Während sich unser Team aktuell auf diese Beta-Phase fokussiert, bleibt der Zugang vorübergehend eingeschränkt. Wir planen, die Erfahrungen aus der geschlossenen Testphase in die weitere Dokumentation, die Veröffentlichungsartefakte und die Zugangsmöglichkeiten für Forschung, Wirtschaft und Open-Source-Community einfließen zu lassen. Die Veröffentlichung wird so bald wie möglich erfolgen.